Real-Time Lip Sync
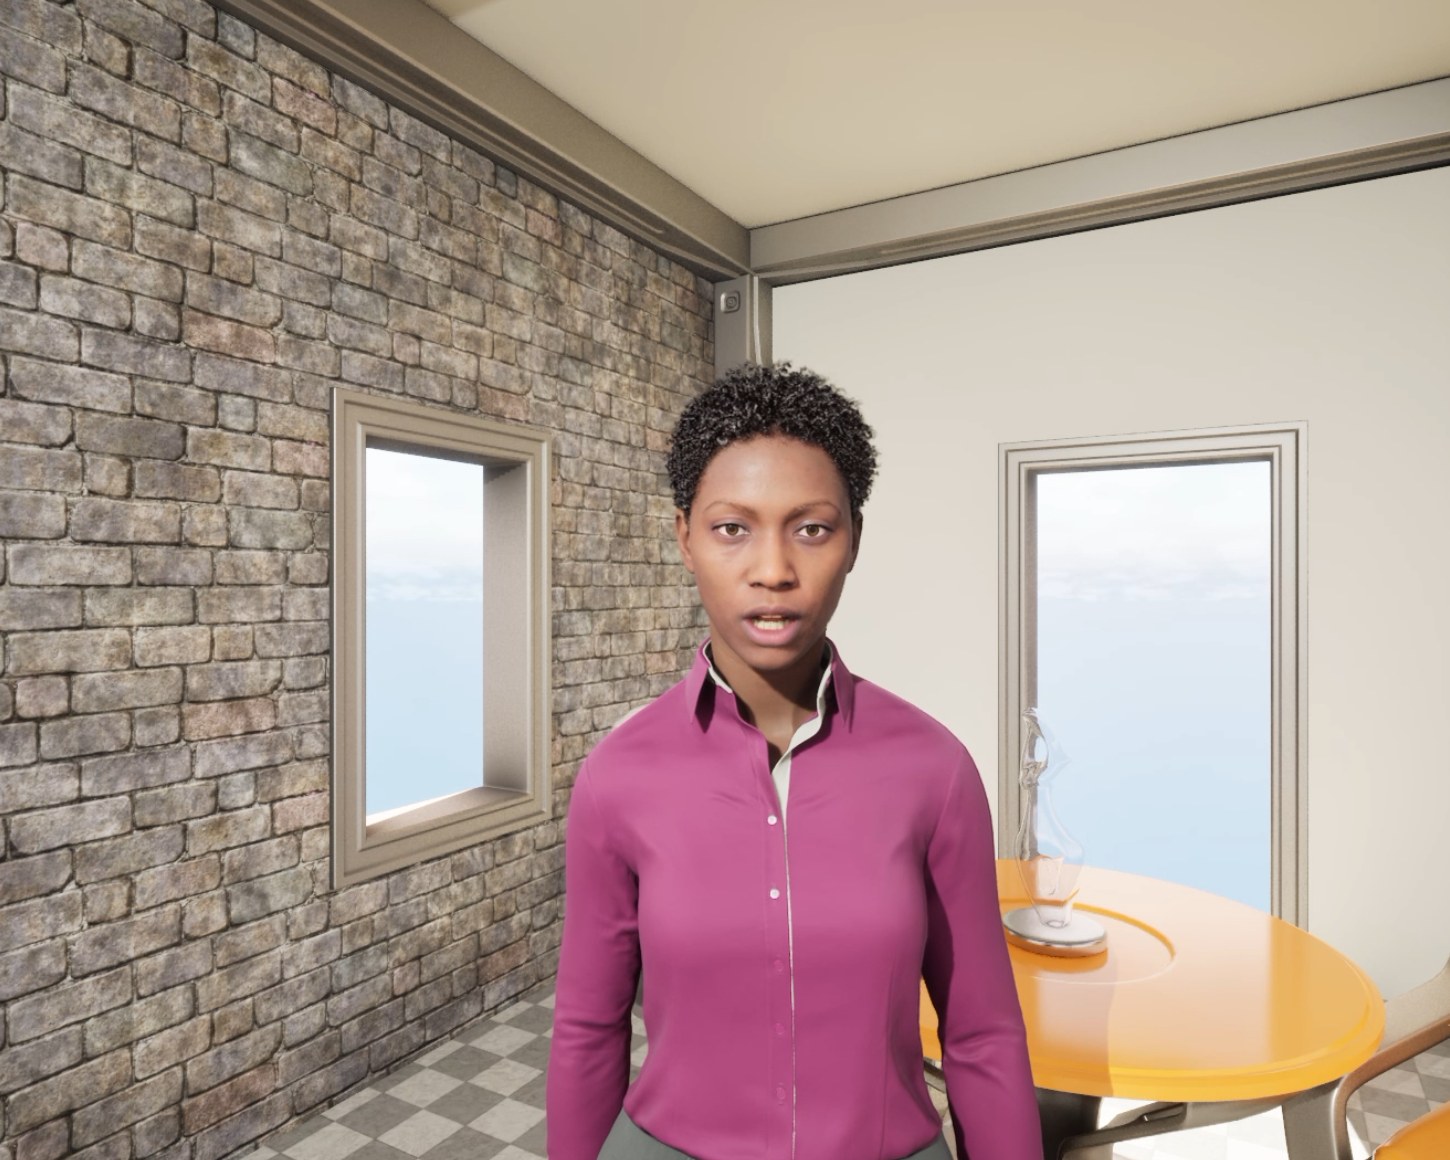
Un client Unreal Engine qui anime en temps réel le visage d'un avatar MetaHuman sur une voix générée par un LLM.
Unreal 5.5C++MetaHumanLiveLink
Le problème
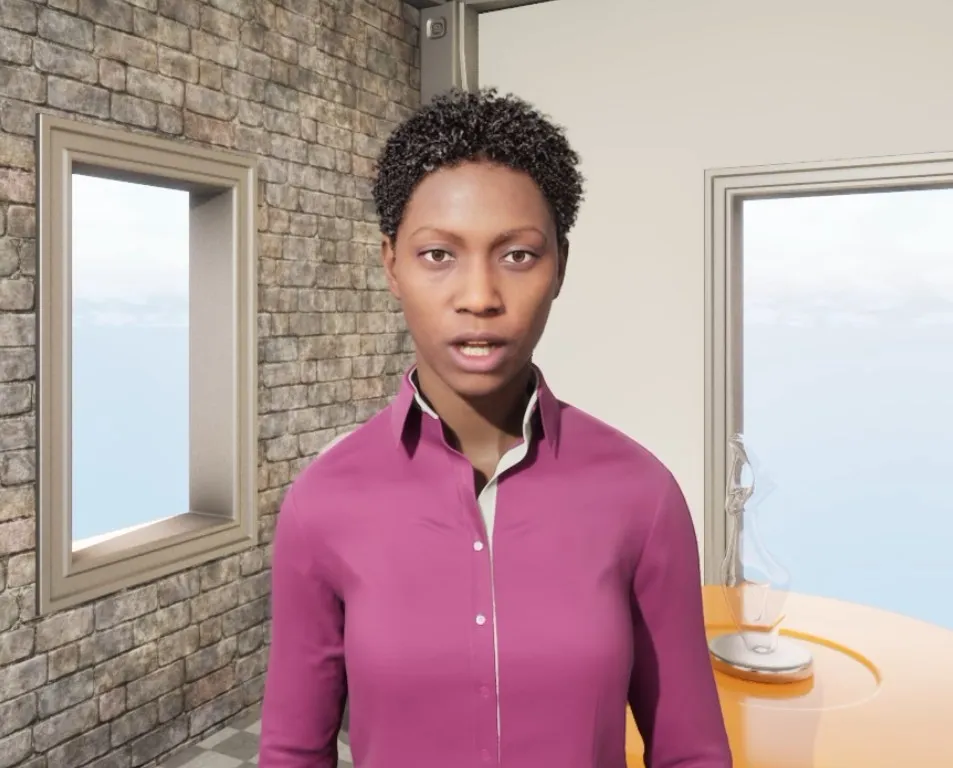
Le projet « Meta-Serious Game » dispose déjà d’une middleware REST qui fait dialoguer le joueur avec des PNJ grâce à un grand modèle de langage (LLM). Mais pendant que le PNJ répond, le client web n’affiche qu’une image fixe : le texte est crédible, la scène ne l’est pas.
L’objectif de ma thèse : un client Unreal Engine où un MetaHuman prononce réellement la réponse, avec une question de recherche précise : quels budgets de latence et de qualité faut-il pour que l’échange paraisse à la fois réactif et crédible ?
Le pipeline
- La middleware renvoie la réponse du LLM et l’audio synthétisé.
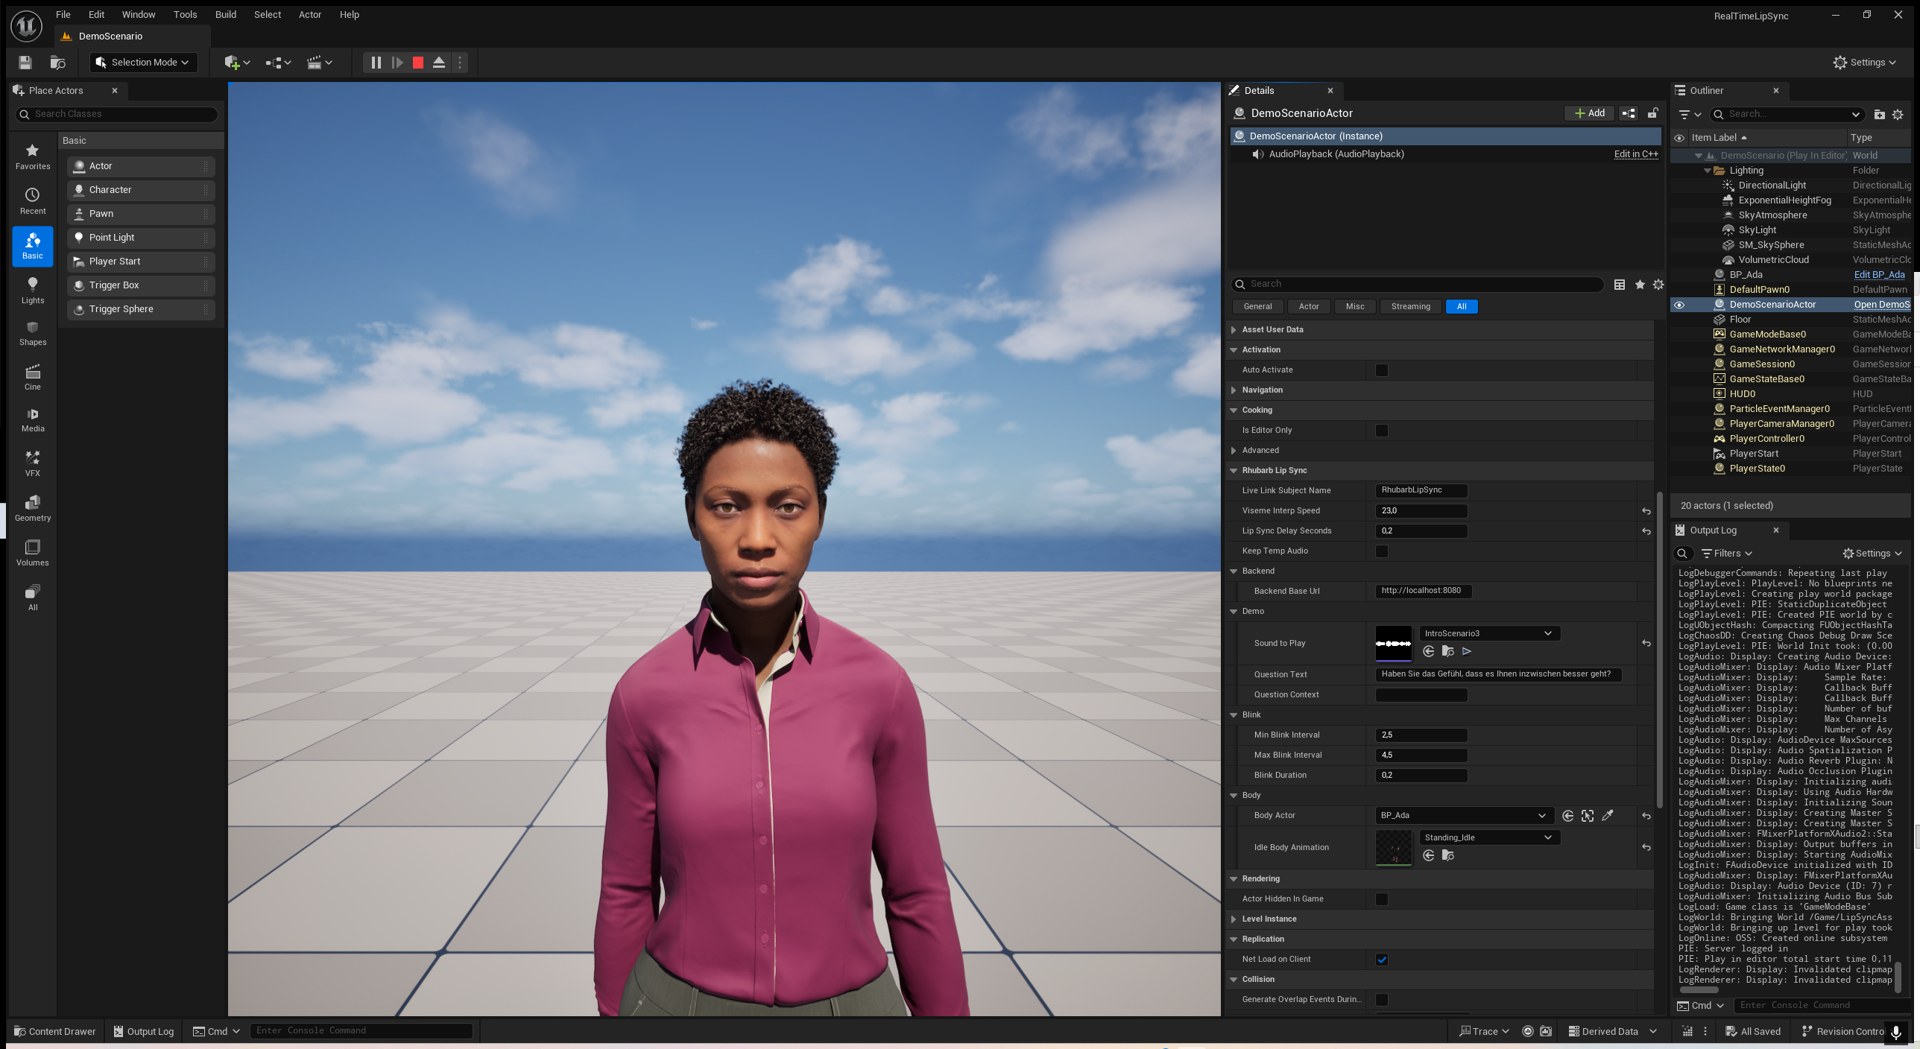
- Le client analyse l’audio avec Rhubarb Lip Sync, qui en extrait une suite de visèmes (les formes de bouche).
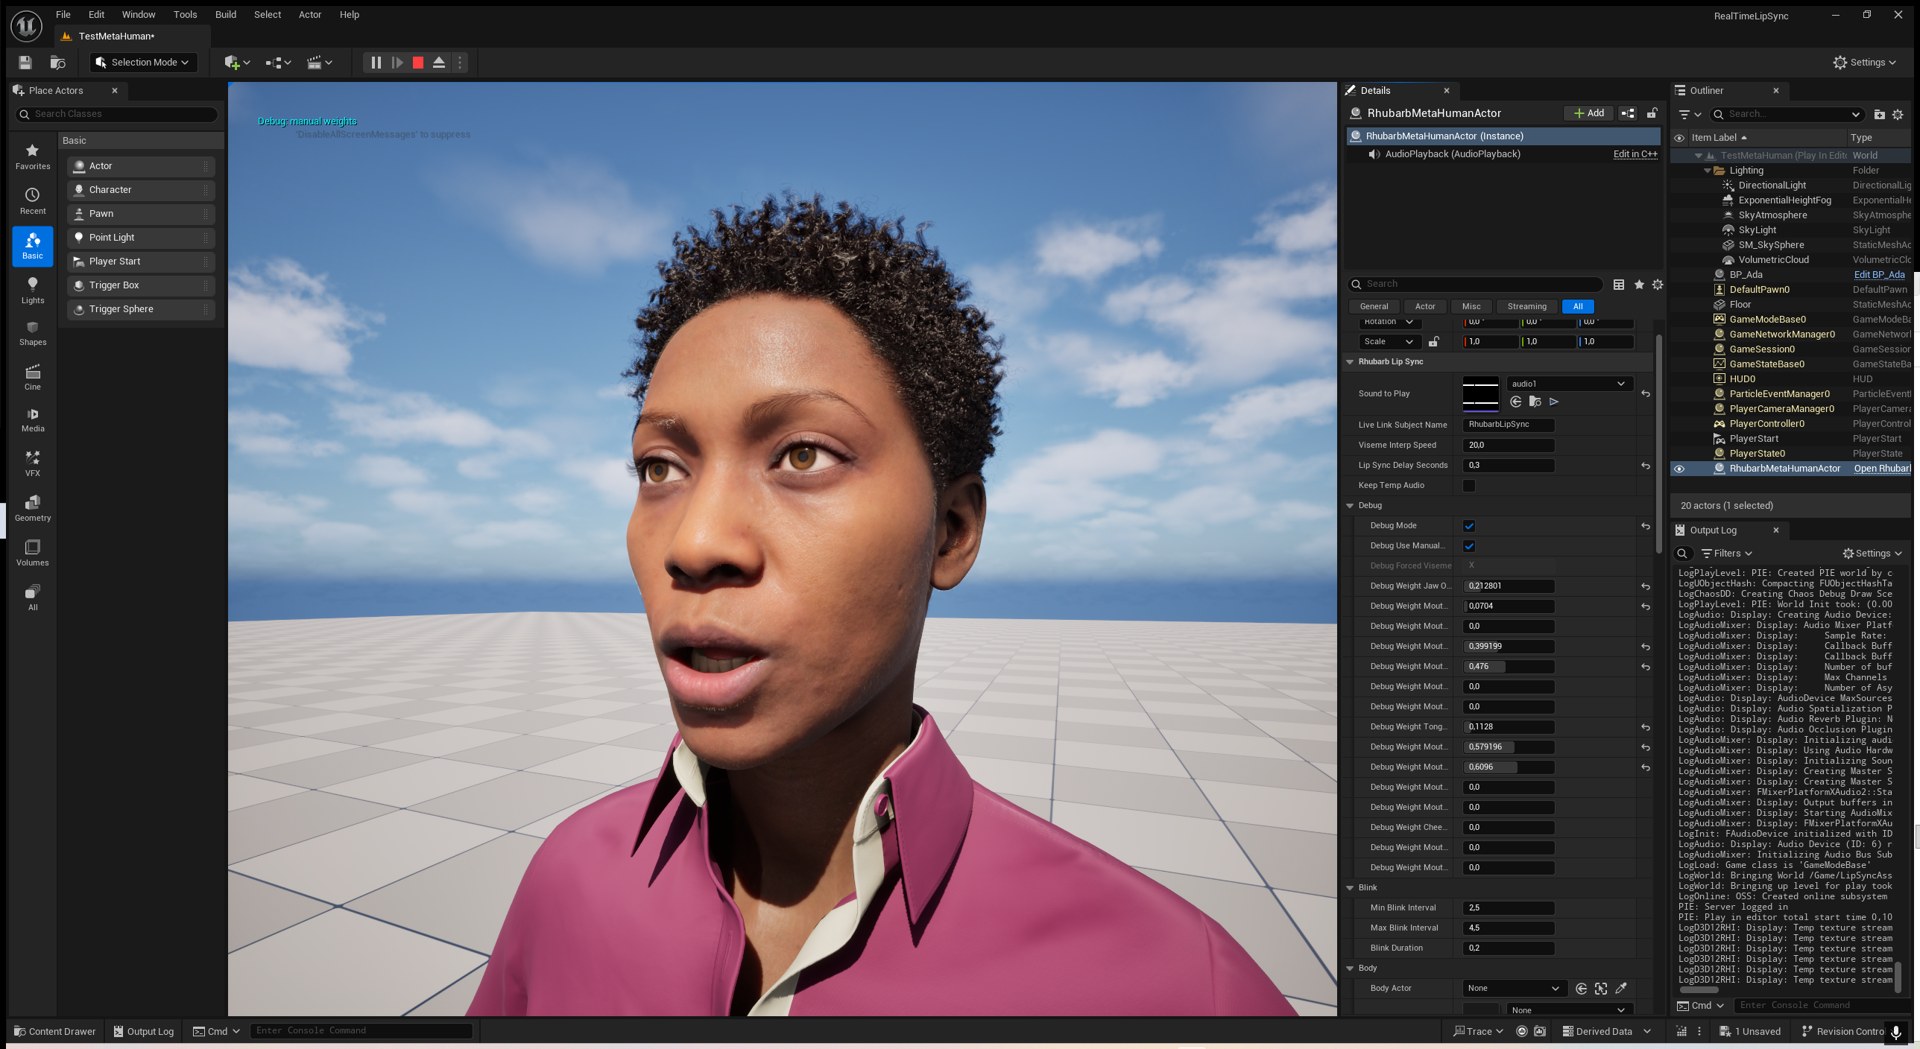
- Chaque visème est converti en courbes de blendshapes ARKit, avec une interpolation pour lisser les transitions.
- Une
ILiveLinkSourceécrite en C++ pousse ces courbes dans le rig facial (RigLogic) du MetaHuman, image par image. - Des animations simples complètent le tout : clignements d’yeux aléatoires et animation d’attente du corps (retargetée depuis Mixamo).
L’évaluation
- Technique : chaque étape du pipeline est chronométrée et enregistrée automatiquement dans un fichier CSV, sur 57 exécutions.
- Perception : une étude pilote en deux tours, à partir de vidéos (15 réponses au total), pour juger la crédibilité de l’animation.
Les résultats
- Environ 2 secondes de latence de bout en bout, réparties presque à parts égales entre l’aller-retour réseau vers la middleware et l’analyse Rhubarb.
- Côté client, l’analyse audio représente à elle seule 99,7 % du temps : c’est le goulot d’étranglement à attaquer en priorité.
- Côté qualité, la simple présence d’un lip sync par visèmes et de quelques animations suffit à rendre l’échange crédible, quelle que soit la finesse du réglage.
Images